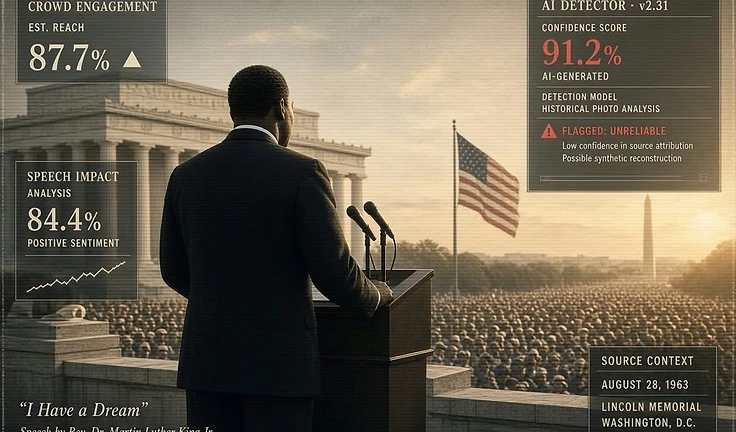
Quatre autres outils le classent humain. Les auteurs, menés par Tadesse Wakjira (Kennesaw State University), estiment qu’aucun de ces logiciels n’offre la fiabilité requise pour des décisions à fort enjeu.
Sur un corpus de 35 textes, l’exactitude globale des six détecteurs testés varie de 14,3 % à 71,4 %. Les pages de présentation de Harvard, du MIT ou de Cambridge sont souvent étiquetées « 100 % IA ».
Cinq outils sur six attribuent à une machine l’article fondateur de Yann LeCun, Yoshua Bengio et Geoffrey Hinton sur l’apprentissage profond, publié bien avant ChatGPT. À l’inverse, des textes absurdes ou truffés de fautes produits par ChatGPT-4o passent pour humains.
Les chercheurs observent qu’un simple mot en moins peut inverser un verdict : sur une page de Stanford, ZeroGPT.com passe de 69,51 % d’IA à 100 % humain. Selon eux, ces outils confondent style soigné et écriture artificielle, alors que discours et articles scientifiques sont par nature structurés. Ils réclament des bancs d’essai ouverts et un contrôle humain de chaque score.
Leur échantillon reste toutefois limité : trois textes artificiels seulement, et uniquement des outils grand public. L’étude est citée alors qu’un roman primé, C’était ça ou mourir de Thélyson Orélien, est soupçonné d’avoir été écrit par une IA sur la foi d’un logiciel, ce que l’auteur dément.
Des tests plus récents, menés en juillet 2026 par Epoch AI sur Pangram, GPTZero et Originality.ai, montrent de bien meilleurs résultats sur des textes humains, mais des failles persistent dès qu’une IA imite un auteur précis. Un pourcentage, conclut l’article, peut ouvrir une vérification, pas la clore.


Aucun commentaire pour le moment. Soyez le premier à réagir.